Audyt, uporządkowanie pomiaru i Server-Side Tagging w sklepie na WooCommerce: EMQ 9.3/10
Podsumowanie
Problem: Tagi analityczne sklepu na WooCommerce były wgrane w trzech miejscach naraz, więc w części przypadków ten sam zakup był liczony nawet dwa albo trzy razy. Panele reklamowe pokazywały przez to ROAS wyższy od rzeczywistego, a jedno ze źródeł duplikatów było ukryte w kodzie niestandardowego modułu sprzedaży pakietów.
Rozwiązanie: Pełny audyt pomiaru, przeniesienie wszystkich tagów do Google Tag Managera jako jedynego źródła prawdy i wdrożenie Server-Side Tagging w konfiguracji same-origin, opartej na Stape i Cloudflare Workers.
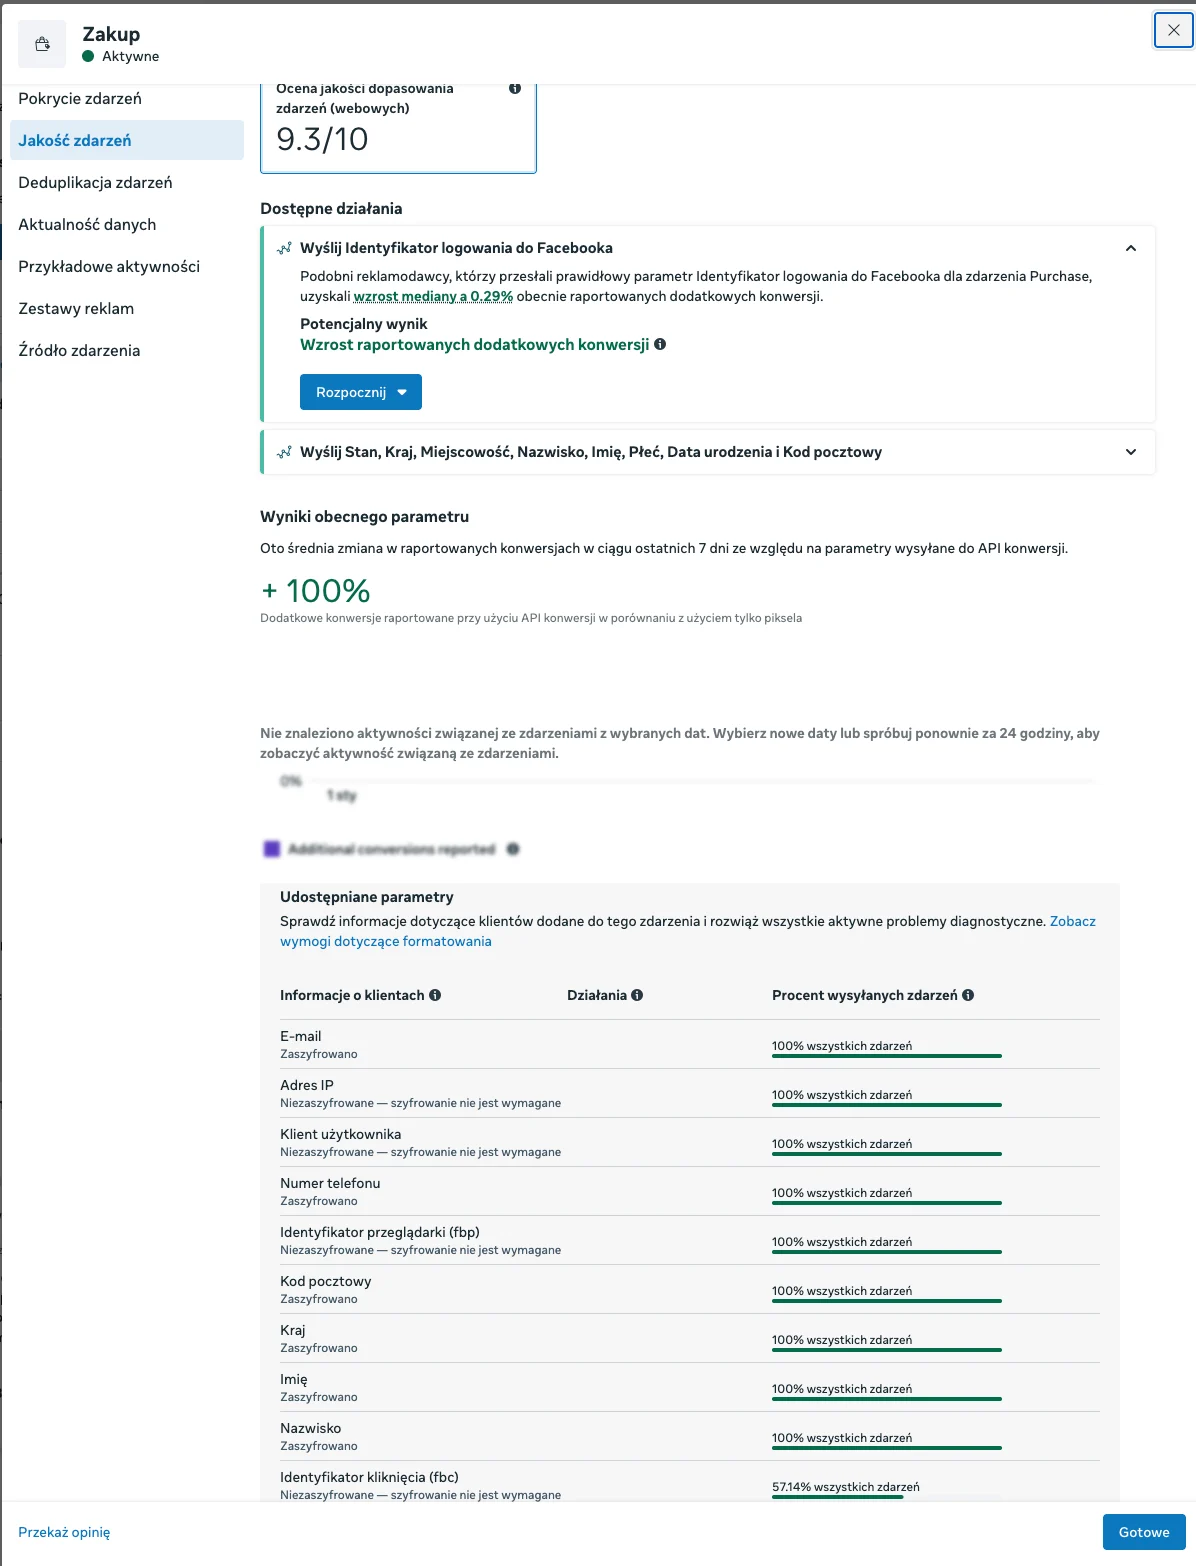
Wynik: Dane w panelach reklamowych przestały zawyżać wyniki i odzwierciedlają rzeczywiste koszty pozyskania klienta. Event Match Quality (EMQ) w Meta wyniósł 9.3/10, a warstwa serwerowa odzyskała 41.2% zdarzeń purchase.
Stack: Google Tag Manager (Web + Server), GA4, Stape, Cloudflare Workers, Meta CAPI, Google Ads, TikTok Ads, CookieYes
Wyzwanie
Co wykazał audyt pomiaru w sklepie na WooCommerce
Sklep internetowy, który przez kilka lat współpracował z różnymi specjalistami, rzadko ma pomiar zbudowany według jednego planu. Każdy kolejny wykonawca dokłada narzędzia potrzebne do prowadzenia własnych kampanii, a narzędzia zainstalowane przez jego poprzednika zwykle nie są usuwane. Po kilku takich zmianach te same zdarzenia są wysyłane jednocześnie przez kilka niezależnych źródeł, a liczby w panelach reklamowych przestają odpowiadać rzeczywistej aktywności użytkowników w sklepie, choć żaden z paneli nie sygnalizuje błędu.
Tak wyglądał przed audytem pomiar w Wdzięcznopisie, rozpoznawalnym polskim sklepie na WooCommerce. Ze sklepem współpracowało wcześniej kilku specjalistów i każdy z nich wdrożył własne narzędzia pomiarowe, w postaci wtyczek albo kodu dodanego bezpośrednio do strony, których później nikt nie usunął.
Projekt zaczął się od audytu i naprawy pomiaru, a decyzja o wdrożeniu Server-Side Tagging, czyli serwera pośredniczącego między przeglądarką użytkownika a platformami reklamowymi, zapadła dopiero w trakcie prac. Taka kolejność ma też uzasadnienie techniczne. Warstwa serwerowa w dużej mierze opiera się na konfiguracji pomiaru po stronie przeglądarki, czyli na tym, jakie zdarzenia i z jakimi parametrami są tam zdefiniowane, więc może działać poprawnie tylko wtedy, gdy ta konfiguracja jest uporządkowana i rzetelna. Dlatego jej wdrożenie musiało zostać poprzedzone uporządkowaniem całego pomiaru, który sklep już miał, czyli tagów, wtyczek, kodu dodanego bezpośrednio do szablonów oraz obsługi zgód. W dalszej części opisuję, co wykazał audyt i jak zawyżone dane wpływały na decyzje budżetowe oraz na pracę algorytmów reklamowych, a następnie kolejne fazy wdrożenia: czyszczenie tagów, pomiar dodawania produktów do koszyka w module sprzedaży pakietów, budowę warstwy serwerowej, konfigurację Meta Conversions API oraz normalizację danych użytkowników, dzięki którym udało się uzyskać wysoki wynik EMQ, wynoszący 9.3/10.
Audyt wykazał zjawisko nazywane zupą z tagów, z którym regularnie spotykam się w sklepach internetowych. Pierwsze objawy zupy z tagów da się wychwycić bez dostępu do kont analitycznych sklepu, korzystając ze skanera trackingu, który przygotowałem do wstępnej diagnozy pomiaru. Wystarczy podać w nim adres wybranej strony, a skaner na podstawie ładowanych na niej skryptów i wysyłanych żądań jest w stanie pokazać ogólny stan trackingu i wykryć najpoważniejsze błędy, na przykład zdublowane tagi albo pomiar, który nie respektuje decyzji podjętej przez użytkownika w banerze zgód.
Pierwsze ustalenie audytu dotyczyło sposobu, w jaki na stronie ładowane były tagi Google. Zamiast jednego źródła, czyli Google Tag Managera, działały trzy niezależne od siebie skrypty, z których dwa wysyłały dane do tej samej usługi GA4, a trzeci do Google Ads. Ich adresy i pochodzenie zestawia poniższa tabela:
Skrypt | Źródło | Status |
|---|---|---|
| Przez GTM | Prawidłowe |
| Plugin | Duplikat |
| Wpisany na stałe w kod strony przez dewelopera | Poza GTM |
Tylko pierwszy z tych skryptów był ładowany przez Google Tag Managera. Drugi pochodził z wtyczki WooCommerce, która ładowała GA4 i Google Ads równolegle z kontenerem, a trzeci, tag Google Ads, deweloper wpisał na stałe w kod strony, poza jakąkolwiek kontrolą z poziomu GTM. W efekcie jeden zakup potrafił wygenerować nawet trzy zdarzenia purchase, a każde wyświetlenie strony (page_view) było liczone dwukrotnie. ROAS w panelu Google Ads wyglądał przez to bardzo dobrze, ale nie odzwierciedlał rzeczywistej sprzedaży.
Duplikaty nie były jedynym ustaleniem audytu. Na stronach produktów nie działało zdarzenie view_item, więc pomiar nie rejestrował, które produkty oglądają użytkownicy. Bez tej informacji systemy reklamowe nie mogły objąć remarketingiem dynamicznym osób, które obejrzały produkt, ale nie dodały go do koszyka, a to zwykle najliczniejsza grupa odbiorców takich kampanii. Meta Pixel był zainstalowany przez darmową wtyczkę PixelYourSite, całkowicie odizolowaną od GTM, której działanie można było zmieniać wyłącznie w zakresie przewidzianym w jej ustawieniach. Wtyczka nie obsługiwała niestandardowych modułów sklepu napisanych przez deweloperów, więc zdarzenia z tych modułów nie były przekazywane do Mety.
Poza GTM działał również TikTok Pixel, ładowany bezpośrednio z analytics.tiktok.com. Nie podlegał przez to ustawieniom zgód skonfigurowanym w GTM, więc mógł zbierać dane także od użytkowników, którzy nie wyrazili zgody na śledzenie przez narzędzia marketingowe, co oznaczało potencjalne naruszenie. Na stronie działały ponadto jednocześnie Hotjar i Microsoft Clarity, czyli dwa narzędzia o tych samych funkcjach, z których każde ładowało własny, ciężki skrypt.
Kod Google ukryty w niestandardowym module sklepu
Oprócz wtyczek na stronie działał niestandardowy moduł wielosztuk, czyli system zakupu kilku produktów w pakietach z progresywnym rabatem. Na podstronę z tym modułem kierowana była większość ruchu płatnego, więc to od poprawności pomiaru w tym miejscu zależało, czy dane o kampaniach mają jakąkolwiek wartość.
Podczas analizy kodu okazało się, że deweloper, który pisał moduł, dodał w nim własne wywołanie gtag. To funkcja tagu Google (biblioteki gtag.js), za pomocą której kod strony może wysyłać zdarzenia bezpośrednio do GA4 i Google Ads, z pominięciem Google Tag Managera. Ze wszystkich znalezionych źródeł duplikatów to było najtrudniejsze do wykrycia, ponieważ nie widać go w panelu WordPressa ani na liście wtyczek, a wykryć je można dopiero przy czytaniu kodu niestandardowego komponentu. Wyłączenie wtyczek, które wysyłały dane analityczne, nie usuwało tego źródła duplikatów, ponieważ kod zapisany w szablonie modułu nadal wysyłał zdarzenia niezależnie od GTM.
Jak zniekształcone dane wpływały na ROAS i optymalizację kampanii
Opisane wyżej problemy bezpośrednio wpływały na wskaźniki, na podstawie których ocenia się skuteczność kampanii reklamowych, a także na działanie samych systemów reklamowych. Podstawowym z tych wskaźników w e-commerce jest ROAS, czyli stosunek przychodu z kampanii do wydatków na reklamę, a obok niego koszt pozyskania klienta (CPA). Na tych wskaźnikach opierały się decyzje budżetowe, a dane, z których je wyliczano, nie odpowiadały rzeczywistości.
Część zamówień była raportowana w panelach reklamowych jako dwa, a nawet trzy zakupy, więc panele wykazywały więcej konwersji i wyższy przychód z kampanii, niż sklep faktycznie uzyskał. W efekcie ROAS widoczny w panelach był wyższy od rzeczywistego, a CPA niższy od kosztu, który sklep ponosił w rzeczywistości.
Zniekształcone dane nie ograniczały się jednak tylko do raportów. Systemy reklamowe Google Ads i Meta Ads uczą się na danych przekazywanych przez pomiar, czyli na informacjach o tym, jak użytkownicy zachowują się w sklepie, i na tej podstawie decydują, komu i w jaki sposób wyświetlać reklamy. Nie mają przy tym możliwości sprawdzenia, czy otrzymane dane są poprawne, więc błędny pomiar bezpośrednio przekłada się na błędną optymalizację kampanii.
Rozwiązanie
Jak przebiegało uporządkowanie pomiaru i wdrożenie Server-Side Tagging
Celem projektu było uporządkowanie pomiaru tak, aby dane przekazywane do narzędzi analitycznych i platform reklamowych były kompletne i wiarygodne. Wymagało to zebrania całego pomiaru w Google Tag Managerze, usunięcia zdarzeń rejestrowanych wielokrotnie, uzupełnienia tych, których brakowało, oraz przekazywania platformom reklamowym kompletu danych potrzebnych do optymalizacji kampanii. Dwie pierwsze fazy opisują naprawę pomiaru. Kolejne dotyczą prac wykonanych po decyzji o wdrożeniu Server-Side Tagging, czyli budowy warstwy serwerowej i przekazywania z niej danych do GA4, Mety, Google Ads i TikToka. Konfigurację po stronie platform reklamowych opisuję szczegółowo na przykładzie Mety.
Faza 1. Uporządkowanie tagów i obsługi zgód
Pierwsza faza objęła prace porządkowe, które musiały poprzedzić dalszą rozbudowę pomiaru. Należało usunąć zbędne i powielone źródła danych, przenieść wszystkie narzędzia analityczne i reklamowe do Google Tag Managera oraz dostosować pomiar do mechanizmu zarządzania zgodami. Dopiero na tak uporządkowanej konfiguracji można było budować kolejne elementy wdrożenia.
Prace porządkowe rozpocząłem od najbardziej oczywistego źródła duplikatów, czyli od wtyczki woocommerce-google-analytics-integration, która ładowała GA4 i Google Ads równolegle z GTM. Wyłączenie wtyczki usunęło jedno ze źródeł zdublowanych zdarzeń, ale na stronie nadal działały inne tagi i skrypty, które mogły wysyłać te same dane. Dlatego jeszcze tego samego dnia ponownie sprawdziłem cały pomiar, aby ustalić, które źródła zdarzeń pozostały aktywne.
Ponowne sprawdzenie pokazało, że część zdarzeń nadal była wysyłana z pominięciem GTM, a ich źródła nie było widać ani w panelu WordPressa, ani na liście wtyczek. Ustalenie, skąd pochodzą, wymagało ręcznego przeszukania plików strony, co było najmniej wdzięczną częścią porządków. W plikach strony znalazłem dwa kody analityczne dodane poza GTM. Pierwszy, gtag.js wpisany na stałe w szablon motywu, znajdował się w miejscu, w którym takie kody umieszcza się najczęściej, więc jego wykrycie nie było trudne. Drugi był dużo mniej oczywisty, ponieważ deweloper umieścił go w kodzie modułu wielosztuk, dodanego do sklepu osobno, i jego odnalezienie zajęło znacznie więcej czasu. Oba kody usunąłem.
Poza GTM działały również tagi Mety i TikToka. Meta Pixel był ładowany przez wtyczkę PixelYourSite, a TikTok Pixel przez kod wpisany na stałe w szablon strony, więc oba działały poza kontenerem. Wyłączyłem wtyczkę i usunąłem kod TikToka, aby obie platformy mogły zostać skonfigurowane od nowa w Google Tag Managerze.
Następnie zająłem się narzędziami do analizy zachowań użytkowników. Audyt wykazał, że Hotjar i Microsoft Clarity działały równolegle, choć oba służą do nagrywania sesji i tworzenia map kliknięć. Wyłączyłem Hotjara, ponieważ Clarity oferuje te same możliwości bezpłatnie, bez limitu nagrań i z natywną integracją z GA4. Strona przestała w ten sposób ładować jeden ciężki skrypt i nie straciła przy tym żadnej funkcji.
Po usunięciu wtyczek i kodów wpisanych na stałe przeniosłem do Google Tag Managera wszystkie systemy analityczne i reklamowe, czyli GA4, Google Ads, Meta Pixel i TikTok Pixel. Żaden z tych systemów nie jest już ładowany przez wtyczkę ani przez skrypt wpisany na stałe w kod strony. Od tej chwili GTM jest jedynym miejscem, z którego ładowane są narzędzia analityczne i reklamowe, więc każdą zmianę w pomiarze wprowadza się w jednym miejscu i każda zostaje zapisana w historii wersji kontenera.
Ostatnim etapem pierwszej fazy było poprawne wdrożenie mechanizmu zarządzania zgodami użytkowników i dostosowanie do niego całego pomiaru. Baner CookieYes przekazuje decyzję użytkownika do Google Tag Managera, a każdy tag w kontenerze działa zgodnie z udzielonymi zgodami, zarówno pod względem sposobu działania, jak i zakresu przekazywanych danych.
Faza 2. Pomiar koszyka w module wielosztuk przez DOM scraping
Po pierwszej fazie wszystkie narzędzia były ładowane z jednego miejsca, ale część interakcji użytkowników nadal nie była rejestrowana. Druga faza dotyczyła uzupełnienia tych braków, przede wszystkim w module wielosztuk, ponieważ to na jego podstronę kierowana była większość płatnego ruchu.
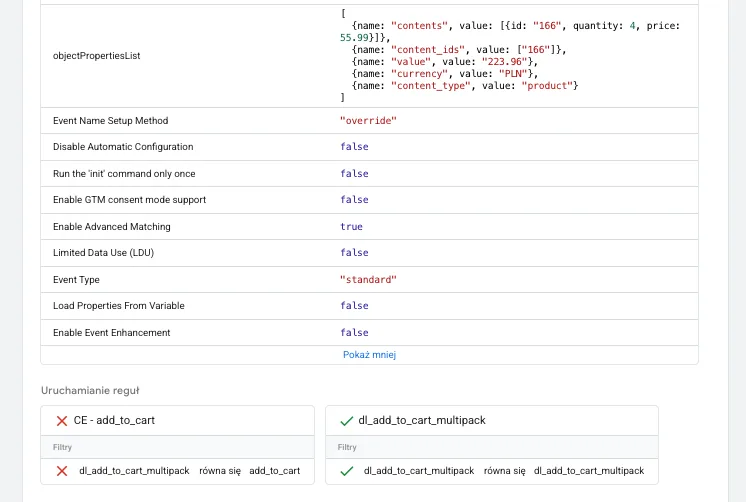
Moduł wielosztuk był najbardziej niestandardowym elementem całego wdrożenia. Działał inaczej niż standardowe mechanizmy WooCommerce, więc wtyczka GTM4WP, która w takich sklepach zwykle odpowiada za tworzenie warstwy danych (Data Layer) dla GTM, nie rozpoznawała generowanych przez niego zdarzeń add_to_cart. Informacje o dodaniu produktu do koszyka w tym module w ogóle nie były rejestrowane.
W takiej sytuacji widać przewagę Google Tag Managera nad wtyczkami, które obiecują kompletny pomiar po jednym kliknięciu. Taka wtyczka zwykle działa poprawnie tak długo, jak sklep korzysta wyłącznie ze standardowych mechanizmów platformy. Jeśli sklep korzysta z niestandardowych rozwiązań, takich jak moduł wielosztuk, wtyczka zwykle ich nie obsługuje, a jej konfigurację można zmieniać wyłącznie w zakresie opcji przewidzianych przez autorów. Pomiaru zdarzeń, których te opcje nie obejmują, nie da się więc w niej skonfigurować. Google Tag Manager nie ma takiego ograniczenia. Można w nim dodawać własny kod, tworzyć i modyfikować reguły uruchamiania tagów oraz definiować zmienne odczytujące dane ze strony. Dzięki temu pomiar w module wielosztuk dało się zbudować od podstaw i dopasować do sposobu jego działania.
Tagi skonfigurowane w GTM zwykle korzystają z danych zapisanych w warstwie danych (Data Layer), którą w sklepach na WooCommerce najczęściej tworzy wtyczka. Moduł wielosztuk nie przekazywał do niej informacji o wybranym produkcie, liczbie sztuk ani cenie, więc jedynym źródłem informacji o wybranym pakiecie była struktura HTML samego modułu. Odczytywanie danych bezpośrednio z tej struktury nazywa się DOM scrapingiem i zwykle nie polecam tej metody, ponieważ jest krucha: każda zmiana w szablonie potrafi ją zepsuć bez żadnego sygnału błędu. W tym przypadku nie było jednak innego sposobu na pozyskanie tych danych, więc napisałem własny skrypt, który osadziłem przez GTM na stronie z modułem wielosztuk:
Skrypt reaguje na kliknięcia w widżecie wielosztuk, odczytuje dane produktu z atrybutów HTML (data-product-id, data-base-price), oblicza cenę po rabacie progresywnym i dodaje do Data Layer poprawne zdarzenie dl_add_to_cart_multipack. Całość jest objęta blokiem try/catch, ponieważ skrypt zależny od struktury HTML musi w razie błędu zakończyć działanie bez wpływu na resztę pomiaru i zapisać ostrzeżenie w konsoli przeglądarki.
Najważniejszym szczegółem tego skryptu jest wyczyszczenie obiektu ecommerce (ecommerce: null) przed właściwym zdarzeniem. Bez tego kroku GA4 potrafi połączyć dane z poprzedniego zdarzenia e-commerce z danymi nowego. To zjawisko nazywa się Data Bleeding i jest trudne do wykrycia, ponieważ nie towarzyszy mu żaden komunikat o błędzie. Zdarzenia są rejestrowane, tylko z danymi częściowo przeniesionymi z poprzedniego zdarzenia, a jedynym objawem są liczby w kolejnych etapach lejka zakupowego, które przestają się ze sobą zgadzać.
Faza 3. Wdrożenie Server-Side Tagging w konfiguracji same-origin
Dwie pierwsze fazy uporządkowały pomiar w przeglądarce i uzupełniły zdarzenia, których wcześniej nie rejestrowano. Kolejnym etapem projektu było wdrożenie Server-Side Tagging, czyli sposobu pomiaru, w którym dane nie są wysyłane z przeglądarki bezpośrednio do Google, Mety czy TikToka, tylko najpierw docierają do serwera pomiarowego należącego do sklepu i dopiero stamtąd są przekazywane platformom reklamowym. Dla przeglądarki wygląda to jak zwykła komunikacja sklepu z własnym zapleczem, a nie jak wysyłka danych do firm reklamowych. Cały mechanizm opisuję szczegółowo w artykule o tym, jak działa Server-Side Tagging i kiedy naprawdę ma sens, a poniżej przedstawiam cztery korzyści, które zdecydowały o tym wdrożeniu.
Pierwszą z nich jest większa odporność pomiaru na blokery reklam i na ITP (Intelligent Tracking Prevention), czyli wbudowany w Safari mechanizm ograniczania śledzenia. Blokery działają na podstawie list filtrów, na których znajdują się przede wszystkim domeny platform reklamowych i analitycznych, takie jak facebook.com czy google-analytics.com, dlatego żądania wysyłane bezpośrednio do tych domen są blokowane najczęściej. Przy Server-Side Taggingu przeglądarka wysyła dane na adres w domenie sklepu, czyli komunikuje się z tą samą witryną, na której znajduje się użytkownik. Taki ruch nazywa się first-party, a blokery i ITP traktują go znacznie łagodniej niż komunikację z zewnętrznymi domenami reklamowymi. Mimo znacznie większej odporności należy jednak pamiętać, że część żądań nadal może zostać zablokowana. Najbardziej zaawansowane blokery reklam stale się rozwijają i w niektórych przypadkach potrafią rozpoznać komunikację pomiarową także wtedy, gdy odbywa się ona w obrębie domeny sklepu.
Drugą korzyścią jest dłuższy okres ważności plików cookie. Plik cookie to niewielki plik tekstowy, który strona zapisuje w przeglądarce użytkownika. Narzędzia analityczne przechowują w nim identyfikator, dzięki któremu przy kolejnych wizytach rozpoznają tego samego użytkownika i mogą powiązać jego zakup z reklamą klikniętą podczas wcześniejszej wizyty. Okres ważności określa, jak długo przeglądarka przechowuje taki plik, zanim go usunie. Safari skraca go do siedmiu dni dla plików cookie zapisywanych przez skrypty JavaScript. Użytkownik, który kliknął reklamę, a zakupu dokonał po dwóch tygodniach, może więc zostać rozpoznany przez narzędzia analityczne jako nowy użytkownik, a jego zakup może nie zostać przypisany do kampanii reklamowej, z której pochodziła jego wcześniejsza wizyta.
Pliki cookie ustawiane przez serwer w odpowiedzi na żądanie wysłane na domenę sklepu (first-party, HttpOnly) podlegają znacznie łagodniejszym ograniczeniom, zwłaszcza gdy odpowiedź pochodzi z serwera o tym samym adresie IP co strona sklepu. W tym wdrożeniu zapewnia to konfiguracja same-origin opisana niżej. Takie pliki cookie mogą zachować ważność znacznie dłużej niż siedem dni, dzięki czemu narzędzia analityczne mogą rozpoznać powracającego użytkownika także po upływie siedmiu dni i powiązać jego zakup z wcześniejszymi wizytami.
Trzecią jest większa kontrola nad treścią wysyłanych danych, czyli nad payloadem. Każde żądanie jest najpierw odbierane przez kontener serwerowy, w którym reguły ustalone podczas konfiguracji decydują, jakie parametry, w jakim formacie i w jakim zakresie zostaną przekazane do Mety, Google czy TikToka. Na tym etapie można na przykład usunąć parametry, których dana platforma nie powinna otrzymywać, zahashować dane osobowe przed ich przekazaniem albo uzupełnić żądanie o informacje, których przeglądarka nie zna, takie jak dane z systemów sklepu.
Czwartą jest lepsza jakość sygnału. Identyfikatory użytkownika, takie jak zahashowany adres e-mail, fbp, fbc, adres IP czy user agent, można przekazywać także bezpośrednio z przeglądarki. W takim przypadku ich dostarczenie zależy jednak od tego, czy skrypt platformy nie zostanie zablokowany i czy pliki cookie nie zostaną wcześniej usunięte. Warstwa serwerowa jest na te ograniczenia znacznie mniej podatna i pozwala przekazywać identyfikatory w każdym zdarzeniu w ujednoliconej postaci. Im pełniejszy jest ten zestaw, tym lepiej Meta dopasowuje konwersje do użytkowników, a skuteczność tego dopasowania mierzy wskaźnik EMQ.
Czy wdrożenie Server-Side Tagging może się zwrócić przy konkretnym budżecie reklamowym, pomaga oszacować przygotowany przeze mnie kalkulator, w którym wystarczy podać budżet i koszt konwersji.
Jak działa konfiguracja same-origin ze Stape i Cloudflare Workers
O tym, jak skutecznie warstwa serwerowa odzyskuje dane, w dużej mierze decyduje sposób, w jaki przeglądarka komunikuje się z kontenerem serwerowym, a przede wszystkim adres, na który wysyła dane. Kontener serwerowy działa pod własnym adresem, zwykle w subdomenie sklepu, na przykład sst.twojadomena.pl. Przeglądarka może wysyłać dane bezpośrednio na ten adres albo na ścieżkę w głównej domenie sklepu, z której żądania są następnie przekazywane do kontenera. Ten drugi wariant nazywa się konfiguracją same-origin. Zdecydowałem się na konfigurację same-origin, ponieważ żądania pomiarowe są w niej wysyłane pod ten sam adres co pozostałe zasoby sklepu, takie jak podstrony, obrazy czy skrypty. Blokerom reklam i mechanizmom ochrony prywatności znacznie trudniej jest w takiej sytuacji odróżnić je od komunikacji niezbędnej do działania strony. Spośród dostępnych obecnie konfiguracji to rozwiązanie zapewnia największą odporność na blokowanie. W tym wdrożeniu składa się ono z trzech elementów: Cloudflare, kontenera serwerowego na Stape oraz Cloudflare Workera, który je łączy.
Konfiguracja rozpoczęła się od przeniesienia obsługi domeny sklepu do Cloudflare, ponieważ to w tej usłudze działa mechanizm, który przekazuje żądania z głównej domeny do kontenera serwerowego. Cloudflare jest przy tym rozbudowaną infrastrukturą, która poza przekazywaniem żądań oferuje również inne możliwości, takie jak sieć CDN przyspieszająca ładowanie strony czy filtrowanie ruchu botów.
Przetwarzanie danych odbywa się w kontenerze GTM Server, który działa na platformie Stape. Stape zapewnia hosting i utrzymanie serwerowej wersji Google Tag Managera, dzięki czemu sklep nie musi utrzymywać własnej infrastruktury serwerowej. To w kontenerze, zgodnie ze skonfigurowanymi w nim tagami, dane są przetwarzane i przekazywane do GA4, Meta CAPI, Google Ads i TikTok Events API, a każda z tych platform otrzymuje je w formacie, którego wymaga.
Komunikację między domeną sklepu a kontenerem na Stape zapewnia Cloudflare Worker, czyli skrypt działający na infrastrukturze Cloudflare, który pośredniczy w przesyłaniu żądań z przeglądarki do kontenera serwerowego. Worker przechwytuje żądania wysyłane na ścieżkę pomiarową w głównej domenie (wdziecznopis.pl/xxx/...) i przekazuje je do kontenera GTM Server na Stape. Dla przeglądarki i blokerów jest to ruch do domeny wdziecznopis.pl, czyli ruch first-party, który blokery zatrzymują znacznie rzadziej niż żądania kierowane do domen platform reklamowych.
Przesyłanie danych do GA4 przez serwer bez przerwy w pomiarze
Po przygotowaniu infrastruktury serwerowej kolejnym krokiem było skonfigurowanie przesyłania danych do Google Analytics przez serwer zamiast bezpośrednio z przeglądarki. GA4 jest w sklepie głównym źródłem danych o ruchu i sprzedaży, a błąd w konfiguracji kontenera na etapie takiej zmiany może oznaczać lukę w raportach. Dlatego tę zmianę przeprowadziłem etapami, a nie za jednym razem.
W tym celu została założona osobna usługa GA4. Przez kilka dni te same zdarzenia były wysyłane równolegle do obu usług: do dotychczasowej bezpośrednio z przeglądarki, a do nowej przez serwer. Pozwoliło to porównać dane zebrane obiema drogami. Dopiero po upewnieniu się, że dane przesyłane przez serwer są zbieżne z danymi z przeglądarki, przesyłanie przez serwer zostało włączone dla głównej usługi GA4, a tagi wykorzystywane do porównania zostały usunięte. Dzięki temu sklep w żadnym momencie nie pozostał bez działającego pomiaru.
Faza 4. Konfiguracja Meta Conversions API przez Data Tagi Stape
Kontener serwerowy sam w sobie nie przekazuje danych do platform reklamowych. Dla każdej z nich trzeba skonfigurować osobny tag, który wyśle zdarzenia w wymaganym przez nią formacie. W przypadku Mety służy do tego Conversions API (CAPI), czyli interfejs przyjmujący zdarzenia bezpośrednio z serwera.
Popularnym sposobem konfiguracji jest wykorzystanie danych, które kontener serwerowy już odbiera na potrzeby GA4. Klient GA4 w kontenerze przyjmuje wtedy zdarzenia, a tag Meta przekłada je na format wymagany przez Metę. Takie rozwiązanie jest proste i szybkie we wdrożeniu, ale Meta otrzymuje dane automatycznie przełożone z formatu GA4, a kontrola nad tym, jakie parametry i w jakiej postaci zostaną jej przekazane, jest ograniczona.
Format danych, który przyjmuje Meta, różni się w wielu miejscach od formatu używanego przez GA4 i Google Ads, na przykład w sposobie przekazywania informacji o produktach. Żeby mieć pełną kontrolę nad tym, co i w jakiej postaci zostanie przekazane do Mety, zamiast polegać na gotowych szablonach i automatycznych transformacjach, przygotowałem samodzielnie zestaw zmiennych Custom JavaScript (CJS) przeznaczonych wyłącznie dla tej platformy. Obejmują one mapowanie contents i content_ids, normalizację danych użytkowników oraz formaty, których oczekuje Meta.
Dla każdego zdarzenia Meta (PageView, ViewContent, AddToCart, InitiateCheckout, Purchase) skonfigurowałem w GTM Web osobny Data Tag Stape, który wysyła dane do GTM Server. Tam odbiera je Data Client i przekazuje do Meta CAPI z dokładnym mapowaniem pól Event Data i User Data.
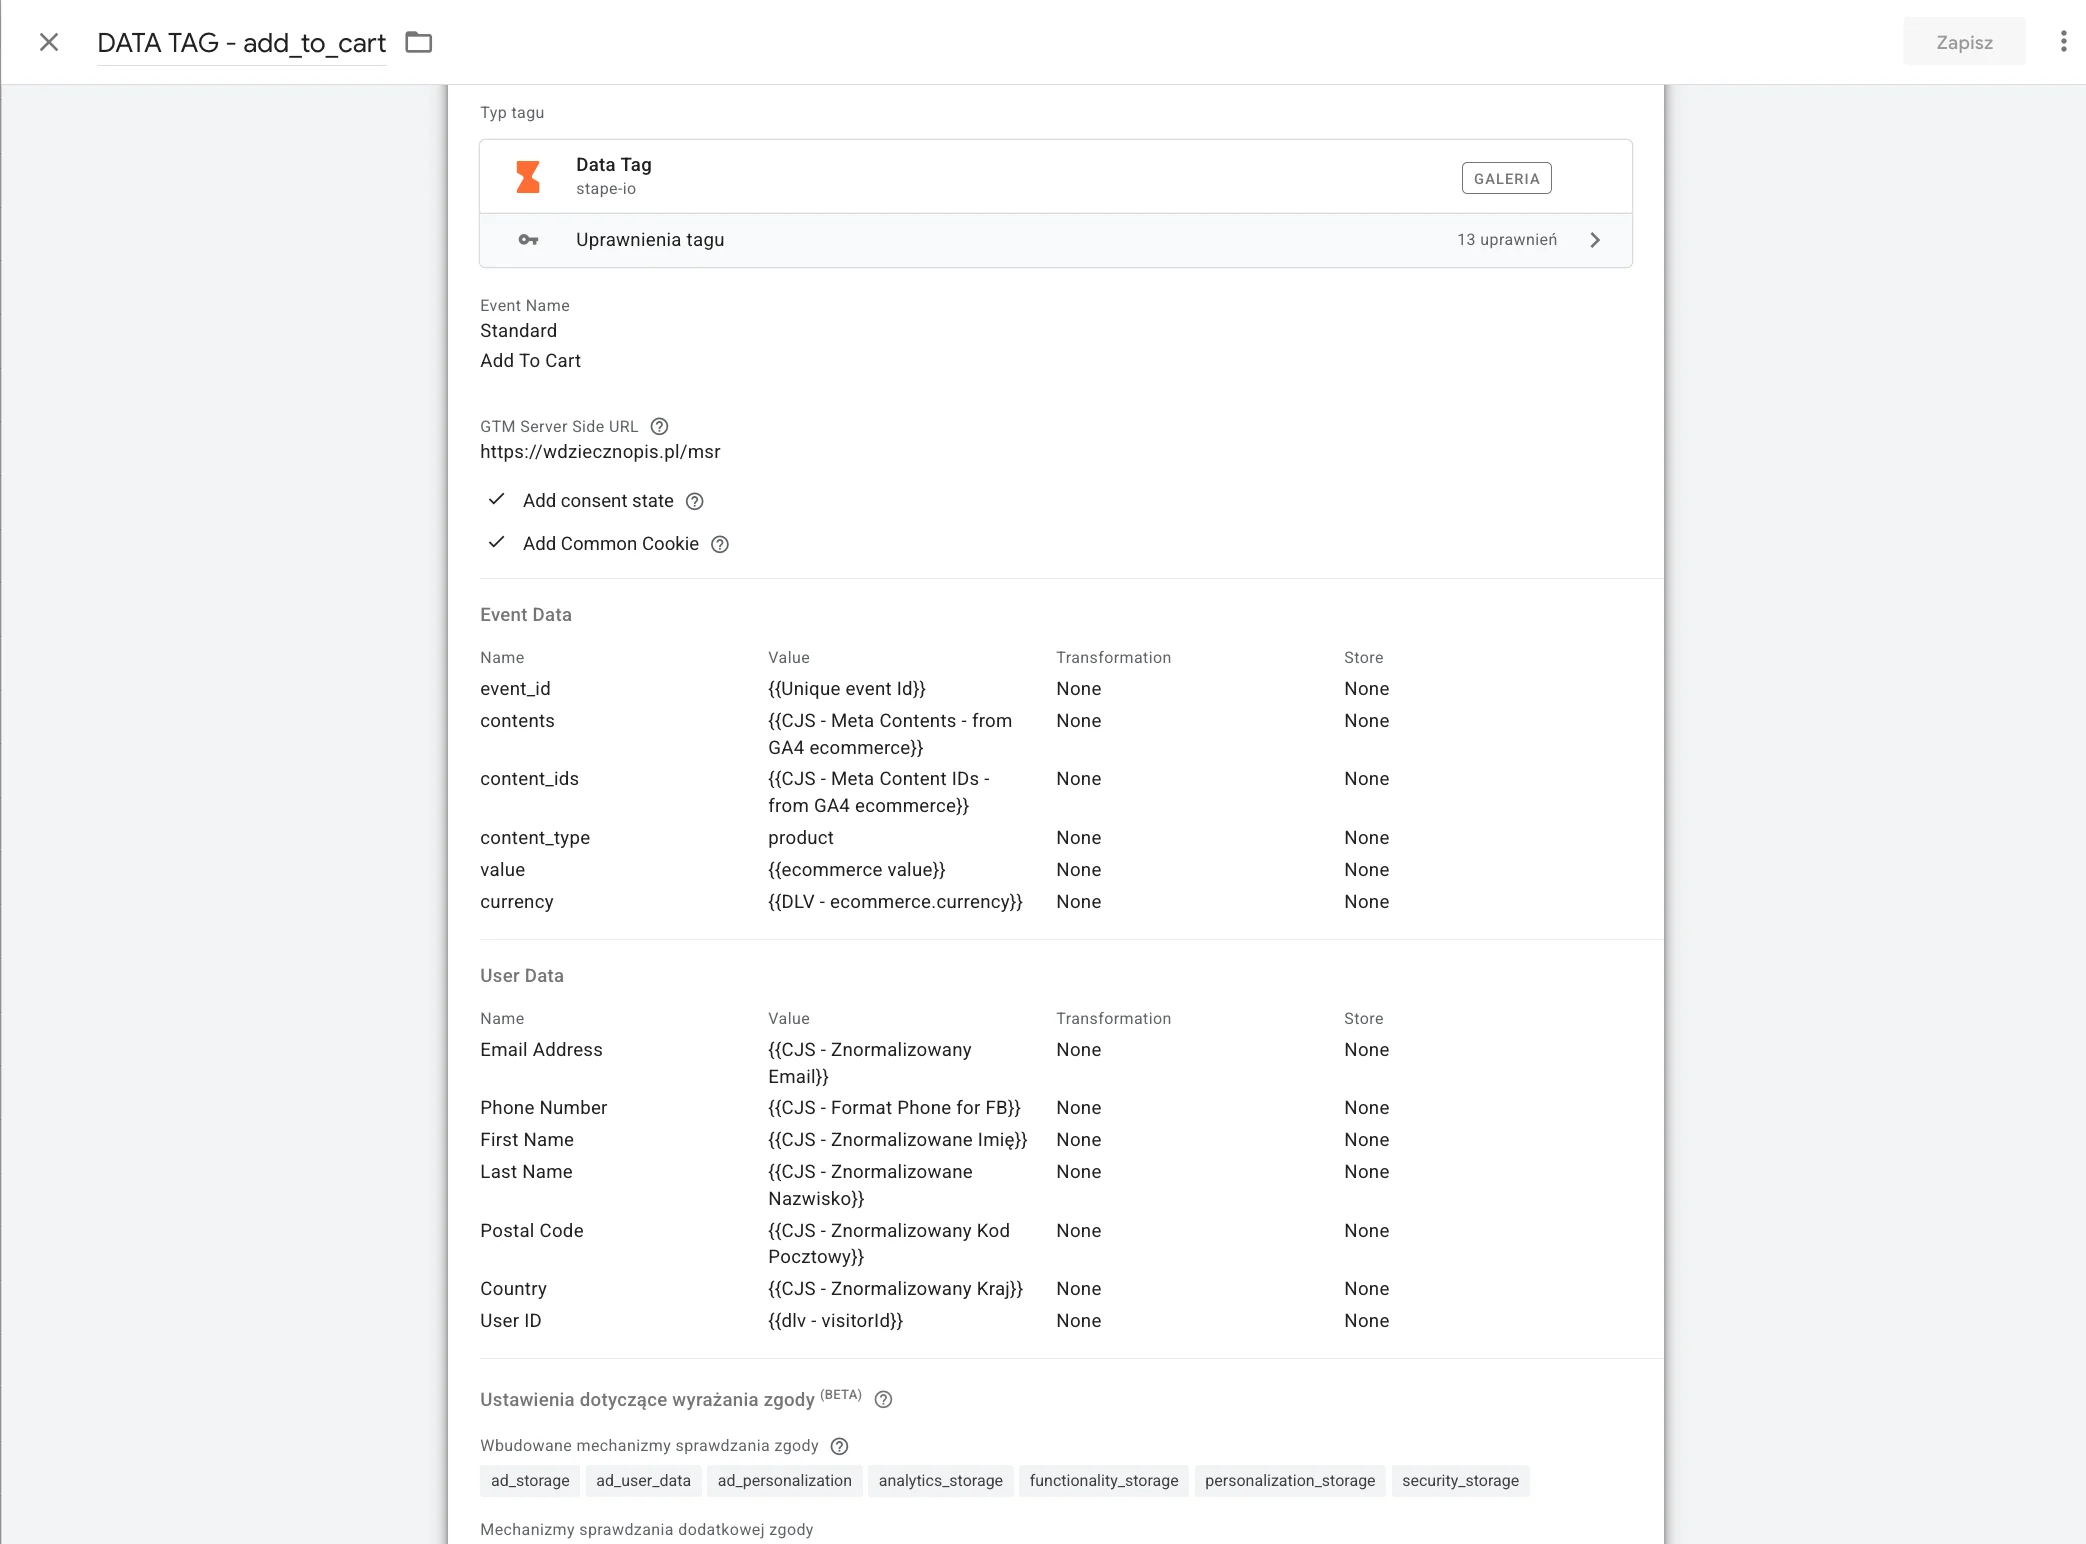
Przykładem takiej zmiennej jest ta, która przekształca tablicę items z GA4 na format content_ids, którego wymaga Meta:
Meta oczekuje content_ids w postaci płaskiej tablicy unikalnych identyfikatorów produktów, natomiast w modelu danych GA4 produkty są zapisane jako tablica obiektów items. Powyższa zmienna przekształca jedną postać w drugą i usuwa przy tym powtórzenia. Kod jest prosty, ale poprawnie przekazane identyfikatory są warunkiem działania reklam dynamicznych. Meta dopasowuje po nich zdarzenia do produktów z katalogu, więc bez nich nie może powiązać produktów oglądanych lub dodanych do koszyka z pozycjami w katalogu ani pokazać ich użytkownikowi w reklamie remarketingowej.
Faza 5. Normalizacja danych użytkowników i wynik Event Match Quality
Event Match Quality (EMQ) to metryka Mety, która w skali od 1 do 10 ocenia, jak dobrze zdarzenia wysyłane z serwera dają się dopasować do użytkowników Facebooka. Im wyższy jest ten wynik, tym lepiej algorytm Mety rozpoznaje, kto dokonał konwersji, i tym precyzyjniej optymalizuje kampanie.
Wynik 9.3/10 jest wyraźnie wyższy od wartości, które zwykle spotyka się na kontach reklamowych sklepów internetowych. Często zdarzenia są tam przekazywane do Mety wyłącznie z przeglądarki i zawierają jedynie podstawowe identyfikatory, takie jak adres IP czy user agent, przez co możliwości dopasowania ich do konkretnych użytkowników są ograniczone. O wysokim wyniku decyduje przede wszystkim przekazywanie jak największej liczby znormalizowanych danych użytkownika: adresu e-mail, numeru telefonu, imienia, nazwiska, kodu pocztowego, miasta i kraju. Każdy dodatkowy, poprawnie sformatowany parametr zwiększa szansę, że Meta rozpozna osobę, która dokonała zakupu.
Trudność polega na tym, że dane wpisywane przez użytkowników są niejednolite. Adres e-mail bywa zapisany wielką literą, a numer telefonu raz z +48, raz z 0048, a raz bez prefiksu. Meta wymaga konkretnego formatu i każde odstępstwo od niego oznacza brak dopasowania. Poniższa zmienna przechwytuje i normalizuje adres e-mail:
O skuteczności tej zmiennej decydują dwa źródła danych. Jeśli użytkownik jest zalogowany, jego adres e-mail jest dostępny od razu, jeszcze przed zakupem. Dzięki temu może być przekazywany do Mety już przy wcześniejszych zdarzeniach, takich jak wyświetlenie produktu czy dodanie go do koszyka, co zwiększa liczbę zdarzeń, które Meta jest w stanie dopasować do konkretnej osoby. Jeśli użytkownik kupuje jako gość, adres pojawia się dopiero w formularzu zamówienia. Na wcześniejszych etapach zmienna korzysta więc z adresu przypisanego do konta zalogowanego użytkownika. Gdy w formularzu zamówienia pojawi się adres podany przy konkretnym zakupie, zmienna przyjmuje go w pierwszej kolejności, ponieważ może się on różnić od adresu przypisanego do konta.
Ujednolicenie adresu ma bezpośredni wpływ na skuteczność dopasowania. Zmienna zapisuje adres małymi literami, usuwa spacje na jego początku i końcu oraz odrzuca wartości, które nie mają formatu adresu e-mail. Jest to konieczne, ponieważ platformy reklamowe nie otrzymują adresu w postaci jawnej, tylko jego skrót utworzony algorytmem hashującym, a ten sam adres zapisany na dwa różne sposoby, na przykład raz wielką, a raz małą literą, daje dwa zupełnie różne skróty. Hashowanie odbywa się automatycznie w szablonach tagów przed wysłaniem danych, a platformy porównują otrzymany skrót z danymi swoich użytkowników, zahashowanymi w ten sam sposób.
Analogiczne zmienne CJS powstały dla pozostałych parametrów użytkownika, czyli dla numeru telefonu, imienia, nazwiska, kodu pocztowego, miasta i kraju. Najwięcej różnic w zapisie występuje w przypadku numeru telefonu, ponieważ użytkownicy wpisują go na wiele sposobów, na przykład ze spacjami, myślnikami albo z prefiksem kraju w różnej postaci. Dodatkowo Meta i Google Ads oczekują numeru w innym formacie: Meta wymaga samego kodu kraju i numeru, bez spacji, znaków specjalnych i plusa, a Google Ads stosuje własne zasady zapisu. Dlatego dla każdej z tych platform przygotowałem osobną zmienną, która sprowadza numer do wymaganego przez nią formatu. Numer zapisany niezgodnie z tymi zasadami nie zostanie dopasowany do użytkownika, a każde takie niedopasowanie obniża EMQ.
Ostatnim elementem tej fazy jest deduplikacja. W konfiguracji z Conversions API to samo zdarzenie jest wysyłane do Mety dwiema drogami, z przeglądarki przez Pixel i z serwera przez CAPI, ponieważ dwie niezależne ścieżki zwiększają pokrycie. Aby uniknąć podwójnego zliczania, oba zdarzenia, przeglądarkowe i serwerowe, są wysyłane z tym samym identyfikatorem event_id, na podstawie którego Meta rozpoznaje je jako jedno zdarzenie.
Wynik
Co zmieniło się w danych po wdrożeniu Server-Side Tagging
Pierwszym widocznym efektem uporządkowania pomiaru był spadek liczby konwersji raportowanych w panelach reklamowych, a razem z nią niższy ROAS. Spadek ten nie oznaczał pogorszenia skuteczności kampanii, ponieważ wynikał z tego, że panele przestały wielokrotnie liczyć te same zakupy. W raportach mógł jednak zostać odczytany jako nagłe pogorszenie wyników reklam, dlatego osoby decydujące o budżecie zostały o nim poinformowane z wyprzedzeniem, razem z wyjaśnieniem jego przyczyny.
Wyniki widoczne w panelach po zmianach były niższe, ale znacznie lepiej odpowiadały rzeczywistej aktywności użytkowników w sklepie. Pozwalają one wiarygodnie oceniać efekty kampanii, a systemy reklamowe Google Ads i Meta uczą się na rzetelnych danych i według nich optymalizują wyświetlanie reklam.
Uporządkowanie pomiaru i wdrożenie Server-Side Tagging wpłynęły na liczbę rejestrowanych zdarzeń w przeciwnych kierunkach. Usunięcie zdublowanych źródeł danych zmniejszyło liczbę konwersji widocznych w panelach, natomiast warstwa serwerowa zaczęła rejestrować zdarzenia, których pomiar w przeglądarce wcześniej nie obejmował, na przykład z powodu blokerów reklam, ITP albo utraty danych podczas przesyłania. Ponieważ Server-Side Tagging został wdrożony dopiero po uporządkowaniu pomiaru, przyrost, który przyniósł, dotyczy zdarzeń wcześniej utraconych, a nie liczonych wielokrotnie.
Skalę tego przyrostu najlepiej widać na zdarzeniach zakupowych: dzięki warstwie serwerowej udało się odzyskać 41.2% wszystkich zdarzeń purchase. Poprawiła się również jakość przekazywanych danych. Event Match Quality dla zdarzenia Purchase osiągnął wynik 9.3/10, ponieważ każde zdarzenie zakupowe zawiera komplet parametrów użytkownika, czyli adres e-mail, numer telefonu, imię, nazwisko, kod pocztowy, miasto i kraj. Dodatkowo pliki cookie ustawiane przez serwer w domenie sklepu mogą zachować ważność znacznie dłużej niż siedem dni, co pozwala trafniej przypisywać zakupy powracających użytkowników do kampanii, z których pochodziły ich wcześniejsze wizyty.
Chcesz podobnych rezultatów?
Umów bezpłatną konsultację i sprawdź, jak mogę pomóc Twojemu biznesowi.
Powiązana usługa: Server-Side Tagging →
Powiązane case studies
Jak webhook odzyskał 40% zakupów gubionych przez bramkę płatności
Zobacz case study
Server-Side Tagging w branży Premium Automotive. Spadek CPA o 32%
Zobacz case study