Integracja leadów z CRM, który nie przyjmuje ruchu z zewnątrz
Podsumowanie
Problem: Nowy korporacyjny CRM stał w sieci odciętej od ruchu przychodzącego. Kilkadziesiąt rozproszonych integracji przestało mieć dokąd wysyłać leady z kampanii i landing page'y.
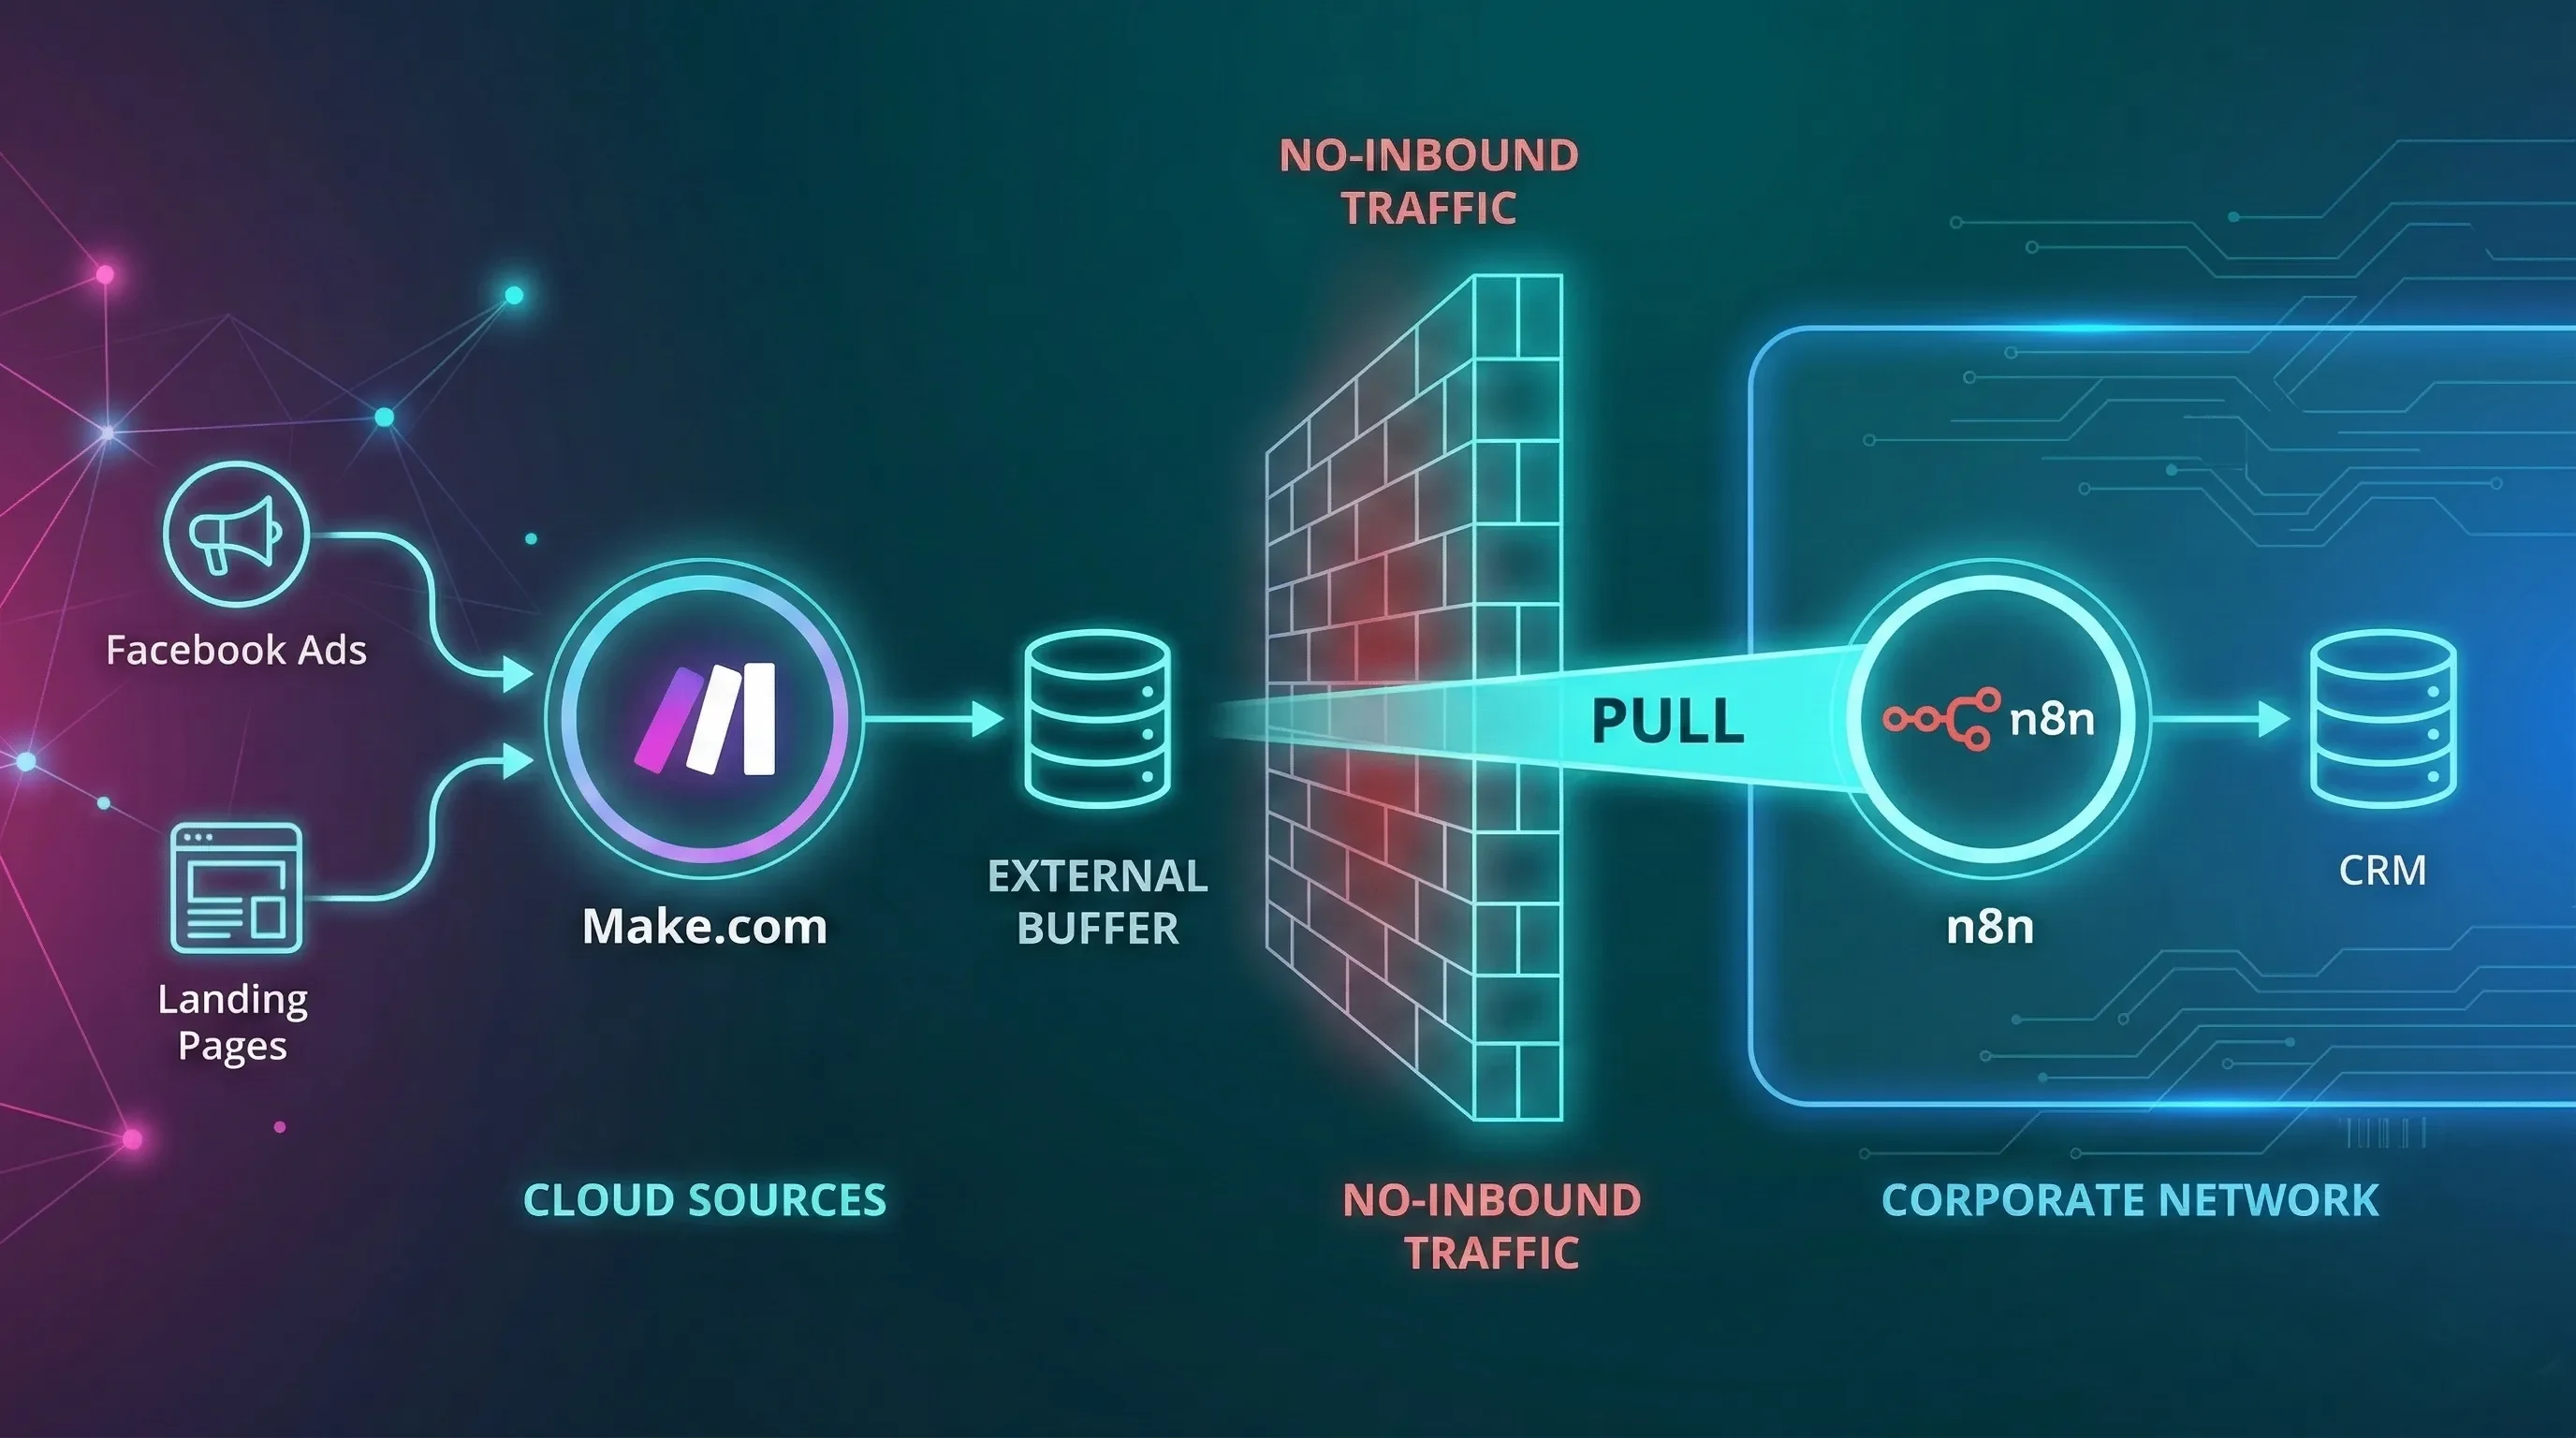
Rozwiązanie: Architektura pull. Bufor w chmurze przyjmuje zgłoszenia, lokalna instancja n8n odpytuje go co pięć minut i sama zapisuje rekordy do CRM przez API. Routing do oddziałów oparty o słownik i ustandaryzowane nazwy kampanii.
Wynik: Ponad osiemdziesiąt automatyzacji sprowadzonych do czterech głównych przepływów. W jednym mierzonym miesiącu 99,9% zgłoszeń przypisanych bez błędu, czyli 2 005 z 2 007.
Stack: n8n (instancja lokalna), Make.com, arkusz w chmurze jako bufor, Facebook Lead Ads, landing page'e, API korporacyjnego CRM
01 / 03
Wyzwanie
Kilkadziesiąt źródeł leadów i CRM zamknięty na ruch przychodzący
Większość integracji między dwoma systemami przebiega tak samo. Jeden system ma publiczny adres, drugi wysyła pod ten adres dane o nowym zgłoszeniu, a cała praca sprowadza się do uzgodnienia formatu i uprawnień.
Ten projekt zaczął się od informacji, że do tego systemu nie da się niczego wysłać z zewnątrz. Grupa dealerska z kilkoma salonami przechodziła na nowy, korporacyjny CRM, który miał własne API i działał bez zarzutu, ale wyłącznie wewnątrz ich sieci. Od strony internetu nie prowadziło do niego żadne wejście. W sezonie przez formularze i kampanie tej grupy przechodziło od dwóch i pół do trzech tysięcy zgłoszeń miesięcznie i wszystkie musiały gdzieś trafić. Opisuję niżej, jak powstała ta integracja i dlaczego najbardziej pracochłonna część pracy nie polegała na budowaniu automatyzacji.
Razem z CRM-em trzeba było przepiąć wszystko, co dotąd zasilało stary system. Zastałem kilkadziesiąt landing page'y, z których część rotowała wraz z kampaniami, pięć kont reklamowych na Facebooku i dziesięć oddziałów, do których te zgłoszenia trzeba było skierować. Każde źródło miało własną integrację, więc każda nowa kampania oznaczała kolejną.
Przy okazji wyszedł drugi problem, który w starym układzie trwał od dawna. Handlowcy dostawali techniczne nazwy kampanii zamiast czytelnej informacji o tym, skąd przyszedł kontakt, oraz numery telefonów w formacie, którego API CRM nie przyjmowało. Skoro i tak przepinaliśmy wszystko na nowo, to była chwila, żeby przestać przenosić ten bałagan dalej.
Dlaczego przesyłanie leadów mailem nie rozwiązywało problemu
Rozwiązanie zaproponował dział IT i w tych warunkach było ono najprostsze z możliwych. Formularz wysyła wiadomość na wskazany adres techniczny, a po drugiej stronie skrypt odczytuje z niej dane kontaktowe i zakłada z nich rekord w CRM. Ten wzorzec ma nawet własną nazwę, e-mail to lead, i w wielu firmach obsługuje przepływ zgłoszeń do dziś.
Sam bym po niego nie sięgnął, ale nie odrzuciłem go dlatego, że jest prymitywny. Przy niewielkim ruchu i jednym odbiorcy zgłoszeń takie rozwiązanie potrafi działać latami, a firma, która je ma, nie zyskuje niczego na wymianie.
Problem nie leżał w transporcie. Leżał w tym, co system ma ze zgłoszeniem zrobić dalej.
Mail dowozi wiadomość, a potrzebny był rekord. Skrzynka pocztowa nie jest kolejką ze stanem. Nie ma w niej pola, w którym automat zapisze, że to konkretne zgłoszenie zostało już przyjęte przez CRM, więc wykrycie powtórki i ponowienie po nieudanym zapisie trzeba dobudować od zera. Samą wiadomość trzeba wcześniej rozłożyć z powrotem na pola, a jej układ jest cudzym szablonem, który może się zmienić bez uprzedzenia. Parser oparty na tym układzie pęka w ciszy, a od wartości, które z niego wychodzą, zależy rozdział zgłoszeń między dziesięć oddziałów.
Rekord ma jeszcze jedną przewagę, której nie widać w dniu wdrożenia. W wierszu leży całe zgłoszenie razem z identyfikatorami, więc dołożenie kolejnego pola, na przykład odpowiedzi na pytanie zadane w formularzu, sprowadza się do dopisania kolumny. Na tej samej podstawie da się później odesłać dane o jakości zgłoszenia z powrotem do Facebooka, żeby kampania optymalizowała się pod leady, które faktycznie kończą się rozmową. Przy parsowanej wiadomości każda taka zmiana zaczyna się od wejścia w parser, czyli w najbardziej kruchy element całego układu.
Skala tylko pogłębiała każdy z tych braków. Przy dwóch i pół tysiąca zgłoszeń miesięcznie rekord zgubiony po cichu kosztuje realne pieniądze, zanim ktokolwiek zdąży się zorientować, że go brakuje.
Webhook, tunel i mail, czyli trzy drogi, które odpadły
Najwięcej czasu w tym projekcie zajęły rzeczy, których w opisie architektury nie widać. Przekopanie się przez dokumentację korporacyjnego CRM i jego API, załatwienie tokenów dostępu, rozmowy z działem IT, w których ustalaliśmy, co wolno, a czego nie, wreszcie zaprojektowanie całości pod te ograniczenia. Same przepływy w Make i n8n powstały na końcu i były najprostszą częścią tej pracy. Odpadły przy tym trzy możliwe rozwiązania i każde z innego powodu.
Webhook na CRM odpadał już na starcie, bo nie dało się otworzyć portu ani dopisać adresów chmury do listy dozwolonych. Taka była polityka bezpieczeństwa korporacji i nikt z nas nie miał na nią wpływu. Powód był twardy i czysto techniczny, więc nie zostawiał pola do negocjacji.
Tunel, czyli Cloudflare Tunnel albo podobne narzędzie, dałby ruch przychodzący bez otwierania portu i w wielu firmach tak się ten problem rozwiązuje. Tutaj odpadł, bo oznaczał wprowadzenie do firmowego środowiska kolejnego nowego narzędzia, a dział IT nie był tym zainteresowany. To jest wystarczający powód i nie ma sensu go podważać, bo decyzja o tym, co działa wewnątrz ich sieci, należy do nich.
Mail z parsowaniem odpadł z powodu opisanego wyżej, bo dowoziłby wiadomość tam, gdzie potrzebny był rekord ze stanem.
Tylko jeden z tych trzech powodów był techniczny. Dwa pozostałe to decyzje ludzi i kształt organizacji, a właśnie na nich rozbija się większość integracji w dużych firmach.
02 / 03
Rozwiązanie
Architektura pull: Make.com w chmurze i n8n w sieci klienta
Skoro do sieci klienta nic nie może wejść, nasuwa się jeden wniosek: trzeba odwrócić kierunek i sięgnąć po dane od środka. Wniosek jest słuszny, tylko zamyka dokładnie połowę problemu. Lokalna instancja n8n potrafi zapisać dane do CRM, bo stoi obok niego w tej samej sieci, i potrafi sama sięgnąć po coś na zewnątrz. Nie potrafi natomiast przyjąć zgłoszenia przysłanego przez Facebooka, bo Facebook musiałby mieć dokąd je wysłać, a serwer bez publicznego adresu z punktu widzenia internetu nie istnieje. Stąd dwie części, które nigdy się ze sobą nie łączą, i bufor postawiony dokładnie między nimi.
Data Flow: Facebook Lead Ads / landing page → Make.com → bufor → n8n (lokalne) → API CRM
Po stronie chmury Make.com odbiera zgłoszenia z formularzy Facebooka i z landing page'y, i zapisuje je jako wiersze ze statusem NEW do bufora, którym jest zwykły arkusz. Po stronie sieci klienta lokalna instancja n8n co pięć minut odpytuje bufor o rekordy nieprzetworzone, normalizuje je, zapisuje do CRM przez API i odsyła status SENT albo FAILED. Dla zapory jest to zwykły ruch wychodzący, taki sam jak każde inne zapytanie do usługi w chmurze.
Miejsce, w którym stanął bufor, też nie było przypadkowe. W restrykcyjnych środowiskach korporacyjnych ruch wychodzący do usług Google bywa dopuszczony domyślnie, więc odpadła osobna procedura odblokowania kolejnego adresu.
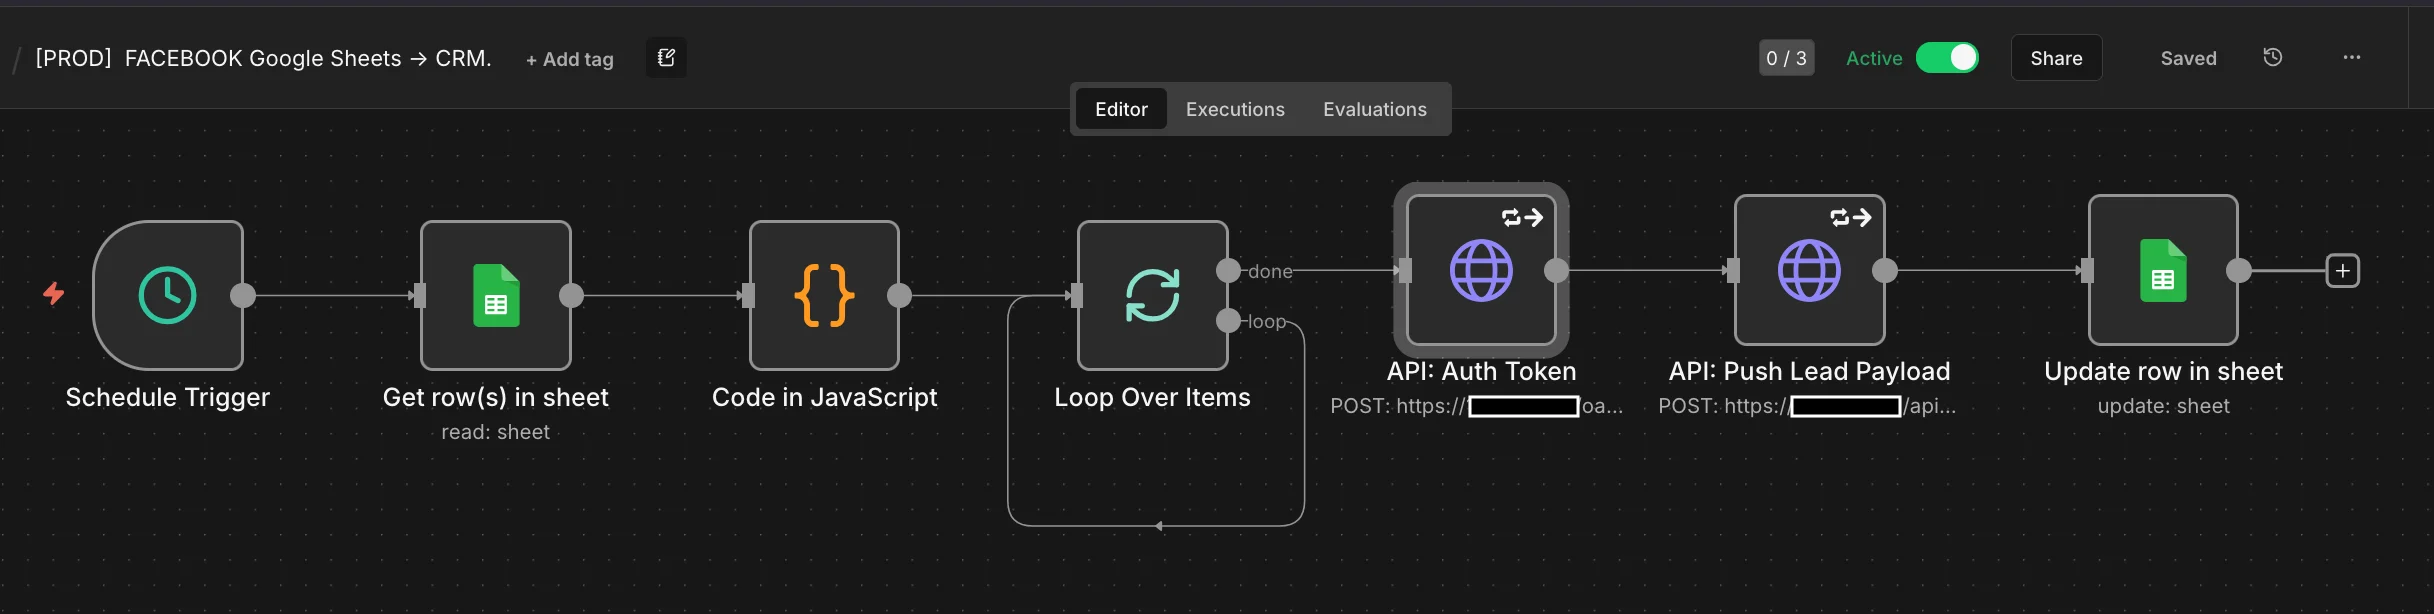
Ten układ ma swoją cenę. Zgłoszenie pojawia się w CRM z opóźnieniem do pięciu minut, bo tyle wynosi odstęp między jednym a drugim odpytaniem bufora. Czas reakcji na leada w tej branży nie jest liczony w pojedynczych minutach, więc takie opóźnienie mieści się w akceptowalnym przedziale.
Paczkowanie także było wyborem, a nie ograniczeniem narzędzia. n8n pobiera zgłoszenia po pięć, przez węzeł pętli, żeby skokowy napływ z kampanii nie zadławił API CRM i nie wywołał odmowy przyjęcia. Błąd jednego rekordu nie przerywa pętli, bo rekord dostaje status błędu i czeka na sprawdzenie, a pozostałe cztery trafiają do CRM. Łatwo za to pomylić kolejność dwóch ostatnich operacji w tej pętli. Status zmienia się dopiero po potwierdzeniu zapisu przez CRM, nigdy po samym wysłaniu żądania. Od tej jednej decyzji zależy, czy przy zerwanym połączeniu powstanie duplikat, czy rekord wróci do kolejki.
Routing leadów po nazwach kampanii zamiast integracji na każdą akcję
Rozdział zgłoszeń między oddziały nie jest trudny technicznie, bo sprowadza się do logiki w jednym węźle. Decyduje za to o tym, czy po roku ktokolwiek chce jeszcze tego systemu używać, i właśnie jego najłatwiej zrobić na skróty.
Skrót polega na tym, że pod każdą kampanię powstaje osobny scenariusz z zaszytym na sztywno identyfikatorem oddziału. Taki scenariusz działa od pierwszego dnia i przestaje wystarczać w miesiącu, w którym marketing uruchamia kilka akcji naraz. Tak właśnie powstało kilkadziesiąt automatyzacji które zastałem.
Routing działa więc automatycznie i składa się z dwóch elementów. Pierwszym są ustandaryzowane nazwy kampanii na Facebooku. Marketing, zakładając kampanię, trzyma się konwencji, w której nazwa niesie informację o oddziale i o typie akcji. Drugim jest słownik, czyli tabela tłumacząca fragmenty tych nazw na identyfikatory oddziałów i zespołów po stronie CRM. n8n czyta nazwę kampanii, znajduje dopasowanie w słowniku i przypisuje zgłoszenie do właściwego oddziału i zespołu.
Nowy oddział albo zespół sprzedażowy wymaga dopisania jednej pozycji w słowniku, zapisanym w węźle z kodem. Poza tą jedną sytuacją nikt nie modyfikuje przepływu, a struktura sprzedaży zmienia się znacznie wolniej niż plan kampanii. Cała bieżąca praca marketingu przebiega bez ingerencji technicznej. To jest odpowiedź na problem z początku tej historii, w której każde nowe źródło oznaczało kolejną integrację do zbudowania i kolejną do zepsucia.
Landing page'e routują tym samym mechanizmem, tylko klucz jest inny, bo tam nazwa kampanii nie występuje. Zastępuje ją struktura ukrytych pól formularza. Dwa źródła, dwa różne klucze, jeden słownik po drugiej stronie.
W tym samym miejscu odbywa się normalizacja, czyli praca, której handlowcy nigdy nie widzą i widzieć nie powinni. Węzeł w JavaScripcie rozdziela imię i nazwisko wpisane w jedno pole, sprowadza numery telefonów do formatu z prefiksem, którego wymaga API, i zamienia techniczne nazwy kampanii na czytelną informację o źródle kontaktu. Do CRM trafia rekord, którego handlowiec nie musi poprawiać przed telefonem. Numer nadaje się do wybrania od razu, a w miejscu technicznego oznaczenia kampanii stoi jedno zdanie mówiące, czym ten człowiek się interesował. Jeśli numer nie przechodzi walidacji, bo ktoś wpisał w to pole słowo zamiast cyfr, rekord dostaje status błędu i zostaje w buforze z odpowiednim statusem, zamiast wywracać całą paczkę.
Jedna zasada pracy marketingu zmienia się w tym układzie na stałe. Od momentu, w którym routing czyta nazwy kampanii, nazwa przestaje należeć wyłącznie do marketingu i staje się interfejsem między dwoma systemami. Literówka w nazwie kampanii nie jest już literówką. Jest zgłoszeniem skierowanym do niewłaściwego oddziału, a zauważy je dopiero handlowiec, kiedy zadzwoni do klienta z drugiego końca miasta.
Dlatego konwencja nie trafiła do dokumentu, o którym trzeba pamiętać. Przygotowałem szablony nazw kampanii bezpośrednio w menedżerze reklam Facebooka, więc poprawna nazwa powstaje w chwili zakładania kampanii i nikt nie musi jej pamiętać ani przepisywać z drugiego okna. Regułę, której przestrzeganie zależy od czyjejś uwagi, ktoś prędzej czy później złamie w piątek po południu. Reguła wbudowana w narzędzie nie daje takiej okazji, bo nazwa powstaje z szablonu, zanim ktokolwiek zdąży się pomylić.
Co się dzieje ze zgłoszeniami, gdy lokalny serwer jest wyłączony
Ten układ nie czekał długo na sprawdzian. Jego wartość zobaczyłem w dniu, w którym jedna z dwóch części przestała odpowiadać.
Zgłoszenia przestały pojawiać się w CRM, choć po stronie konfiguracji nikt niczego nie ruszał. Sam bufor zachowywał się przy tym normalnie, bo chmurowa część układu nie miała powodu przestać działać. Wierszy przybywało, tylko żaden nie zmieniał statusu na przetworzony, więc nikt ich nie odbierał po stronie klienta.
Diagnozę zaczyna się zwykle od otwarcia samego przepływu i przejrzenia ostatnich uruchomień. Tym razem nie dało się nawet zalogować do n8n, a to zawężało pole do jednej przyczyny, bo panel nie odpowiada wtedy, gdy nie odpowiada serwer, na którym stoi. W miejscu, w którym ten serwer stał, trwał remont i na jego czas został wyłączony. Nikt tego nie zapowiedział, bo nikt nie miał powodu łączyć prac budowlanych z przepływem zgłoszeń z reklam. Przerwa trwała kilkanaście godzin.
To jest ten rodzaj zdarzenia, którego nie ma w żadnym planie wdrożenia. Ryzyko nie leżało w kodzie ani w API, tylko w tym, że jedna z dwóch części systemu stała fizycznie w miejscu poza moją kontrolą, a decyzja o jej wyłączeniu należała do kogoś, kto o jej istnieniu nie wiedział.
Gdyby Facebook wysyłał zgłoszenia prosto do CRM, ta przerwa oznaczałaby ich utratę. Platforma reklamowa ponawia dostarczenie przez ograniczony czas, po jego wyczerpaniu przestaje i nie zostawia śladu, z którego dałoby się cokolwiek odtworzyć. Nikt nie poznałby nawet skali straty, bo brakujących zgłoszeń nie da się policzyć w systemie, który ich nie dostał.
Zgłoszenia przez cały ten czas czekały w buforze ze statusem NEW, bo chmurowa część działała niezależnie od tego, co dzieje się ze sprzętem u klienta, a bufor gromadzi wiersze niezależnie od tego, czy ktokolwiek po nie sięga. Po włączeniu serwera zaległość została przesłana paczkami po pięć, w tempie, które API CRM przyjęło bez protestu. Paczkowanie, dołożone wcześniej jako zabezpieczenie przed skokami z kampanii, okazało się przy okazji zabezpieczeniem przed powrotem po dłuższej przerwie.
03 / 03
Wyniki
Wyniki wdrożenia: 99,9% zgłoszeń przypisanych bez błędu
Mechanizm w tym kształcie pracował do dnia, w którym przekazywałem konto. Liczby niżej pochodzą z jednego mierzonego miesiąca.
Ponad osiemdziesiąt rozproszonych automatyzacji sprowadzonych do czterech głównych przepływów, dwóch w chmurze i dwóch w sieci klienta. Reszta konfiguracji przeniosła się do słownika i do konwencji nazewniczej.
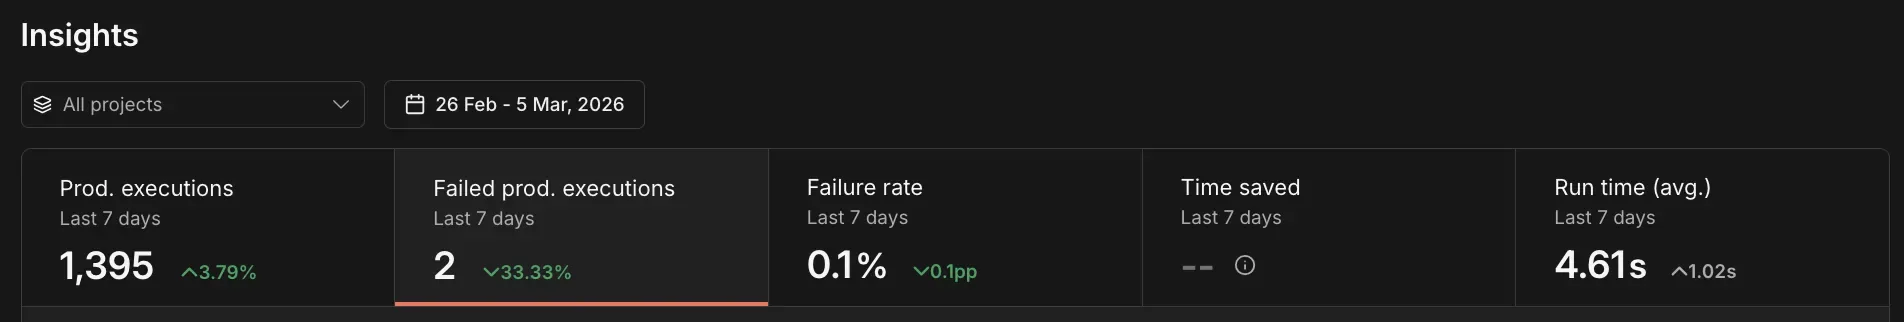
99,9% zgłoszeń przypisanych automatycznie i bez błędu, czyli 2 005 z 2 007 w jednym mierzonym miesiącu. Pomiar pochodzi z miesiąca poza sezonem, a w szczycie przez mechanizm przechodzi od dwóch i pół do trzech tysięcy zgłoszeń.
Jeden mechanizm obsługujący pięć kont reklamowych i kilkadziesiąt landing page'y, z podziałem na dziesięć oddziałów. W mierzonym miesiącu aktywnych źródeł było dwadzieścia, bo część landing page'y rotuje razem z kampaniami.
Nowa kampania nie wymaga pracy technicznej, bo wystarczy nazwa zgodna z konwencją. Słownik uzupełnia się wyłącznie przy nowym oddziale albo zespole sprzedażowym.
Zero ruchu przychodzącego do sieci klienta. Nikt nie musiał robić wyjątku w polityce bezpieczeństwa, a integracja i tak powstała.
Usługa: Automatyzacje →
Chcesz podobnych rezultatów?
Umów bezpłatną konsultację i sprawdź, jak mogę pomóc Twojemu biznesowi.